Dónde se ejecuta el trabajo pesado: CPU, GPU o un nodo
Dos cosas de phonometry tardan lo bastante como para querer una máquina más rápida: hacer avanzar una simulación FDTD, acústica o elástica, y escribir un vídeo de ella. Las dos pueden ejecutarse en esta máquina o en un nodo al que llegas por SSH, y las dos pueden usar una GPU cuando la hay. Esta página es el mapa; cada camino tiene su propia página.
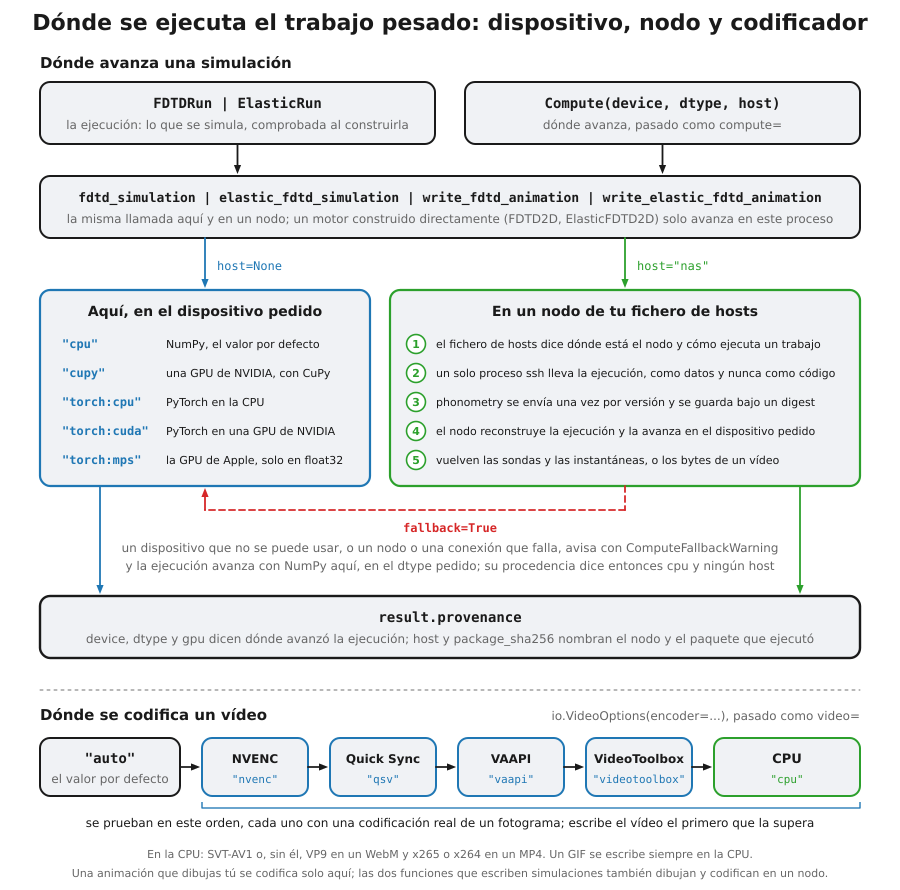
La página en una lámina. Arriba, una ejecución y un registro Compute entran
en una de las cuatro funciones que aceptan un host: sin él la ejecución avanza
aquí, en uno de cinco dispositivos, y con él va a un nodo, en cinco pasos. Los
dos caminos terminan en result.provenance, y fallback=True trae de vuelta a
NumPy, aquí, un dispositivo que no se puede usar o un nodo o una conexión que
falla. Abajo, el orden en que encoder="auto" prueba los codificadores, cada
uno con la codificación de un fotograma.
Dónde avanza una simulación
Sección titulada «Dónde avanza una simulación»Una ejecución es un registro de lo que se simula (FDTDRun, o ElasticRun
para el motor elástico), comprobado al construirlo. Dónde avanza va aparte:
un registro Compute, que se pasa como compute= a fdtd_simulation, a
elastic_fdtd_simulation, a los dos motores y a las dos funciones que
escriben simulaciones, de modo que la misma ejecución avanza en cualquier
sitio. Si no se pasa nada, ningún bloque use() rodea la llamada y
PHONOMETRY_COMPUTE no está definida, avanza con NumPy, aquí, en float64, y
cada resultado registra dónde se ejecutó:
from phonometry import simulation
run = simulation.FDTDRun( c=343.0, dx=0.02, duration_s=4.0e-3, shape=(60, 80), sources=[simulation.GaussianPulse(ix=20, iy=30, half_width_s=3.0e-4)], recording=simulation.FDTDRecording(probes=[(60, 30)]),)res = simulation.fdtd_simulation(run)print(res.provenance.device, res.provenance.host) # cpu None| Dispositivo | Avanza en | Qué instalar | Qué se promete |
|---|---|---|---|
"cpu" |
NumPy, en la CPU de esta máquina | nada | en float64 la referencia, bit a bit; en float32 dentro de una cota publicada |
"cupy" |
una GPU de NVIDIA | el wheel de CuPy para tu versión de CUDA | en float64 los campos bit a bit, según lo medido; en float32 todavía sin cota medida |
"torch:cpu" |
PyTorch en la CPU | pip install torch --index-url https://download.pytorch.org/whl/cpu y después pip install "phonometry[torch]" |
dentro de una cota publicada |
"torch:cuda" |
PyTorch en una GPU de NVIDIA | pip install "phonometry[torch]" |
todavía sin cota medida |
"torch:mps" |
la GPU de Apple, solo en float32 | pip install "phonometry[torch]" |
dentro de una cota publicada en float32 |
En Linux, la fila de la CPU toma primero torch del índice de CPU de PyTorch, porque el torch que sirve PyPI allí trae gigabytes de bibliotecas de CUDA que una CPU nunca usa.
Dónde se calcula una simulación explica
cada dispositivo, el bloque use() y la variable PHONOMETRY_COMPUTE, la
vuelta a NumPy, qué registra provenance además del dispositivo y el host
(el dtype, las versiones con las que se ejecutó, la GPU y el paquete que
ejecutó un nodo) y las mediciones que respaldan la última columna.
Aquí o en un nodo
Sección titulada «Aquí o en un nodo»Si el registro nombra un host, el nombre de una entrada de tu fichero de
hosts (aquí nas), la misma llamada se ejecuta en ese nodo, y el resultado
vuelve como si se hubiera ejecutado aquí:
gpu_node = simulation.Compute(device="cupy", host="nas")res = simulation.fdtd_simulation(run, compute=gpu_node)print(res.provenance.host, res.provenance.gpu) # nas, y el nombre de la tarjetaUn nodo es una entrada de tu fichero de hosts: se llega a él por SSH y
ejecuta la imagen de contenedor del nodo o un entorno de Python propio. Un
trabajo nombra una función de la biblioteca y lleva su ejecución como datos,
nunca código tuyo; el nodo ejecuta el phonometry que tienes aquí, enviado una
vez por versión, y su respuesta se comprueba antes de fiarse de ella. Un motor
construido directamente (FDTD2D, ElasticFDTD2D) avanza en este proceso:
lo mueve tu propio código, paso a paso, y eso no puede viajar.
Enviar una simulación a un nodo remoto
explica el fichero de hosts, la imagen del nodo y de qué se fía cada lado.
Dónde se codifica un vídeo
Sección titulada «Dónde se codifica un vídeo»Un vídeo se dibuja con matplotlib y lo codifica ffmpeg, con un codificador de
CPU o uno de GPU. Cómo se codifica es un registro propio, io.VideoOptions,
que io.write_video y las dos funciones que escriben simulaciones,
simulation.write_fdtd_animation y
simulation.write_elastic_fdtd_animation, toman como video=; sin él, el
codificador se elige solo (encoder="auto"). Escribir un vídeo aquí
requiere pip install "phonometry[plot]" y un ffmpeg en el PATH, que es un
programa y no un paquete de Python. En un nodo ambos son del nodo: su imagen
Docker los lleva, un nodo Python necesita matplotlib en su entorno y ffmpeg
en su PATH, y esta máquina no necesita ninguno salvo que fallback=True
traiga aquí una ejecución fallida.
Una función que escribe una simulación dibuja un fotograma por cada
instantánea que registra su ejecución, así que la cadencia de las
instantáneas es la de los fotogramas: con
recording=simulation.FDTDRecording(snapshot_every=10), o
simulation.ElasticRecording(snapshot_every=10) para el motor elástico,
dibuja el campo en t = 0 y cada diez pasos, y una ejecución que no registra
instantáneas se rechaza con ValueError. La ejecución run de la tabla y
del código de abajo las registra. No se guarda ningún fotograma: el
resultado de la función tiene las sondas, los tiempos y la procedencia, con
snapshots a None.
| Un codificador de CPU | Un codificador de GPU | |
|---|---|---|
| Aquí | io.write_video(path, animation, video=io.VideoOptions(encoder="cpu")): SVT-AV1 o, sin él, VP9 en un WebM y x265 o x264 en un MP4 |
VideoOptions(encoder="auto"), el valor por defecto, prueba NVENC, Quick Sync, VAAPI, VideoToolbox y después la CPU, cada uno con una codificación real de un fotograma |
| En un nodo | simulation.write_fdtd_animation(path, run, compute=simulation.Compute(host="nas"), video=io.VideoOptions(encoder="cpu")) |
simulation.write_fdtd_animation(path, run, compute=simulation.Compute(device="cupy", host="nas"), video=io.VideoOptions(encoder="nvenc")): el nodo calcula, dibuja y codifica. En un nodo Docker, NVENC necesita una ubicación en GPU ("cupy" o "torch:cuda"), la que da su GPU de NVIDIA al contenedor, y el contenedor no recibe ningún otro dispositivo; el ffmpeg de un nodo Python usa lo que tenga su máquina, sea cual sea la ubicación |
from phonometry import io, simulation
io.write_video("wave.webm", animation)   # cualquier animación de matplotlib, codificada aquírun = simulation.FDTDRun(    c=343.0, dx=0.01, duration_s=4.0e-3, shape=(200, 300),    sources=[simulation.GaussianPulse(ix=60, iy=100, half_width_s=3.0e-4)],    recording=simulation.FDTDRecording(snapshot_every=10),)simulation.write_fdtd_animation(    "pulse.webm", run,    compute=simulation.Compute(device="cupy", host="nas"),    video=io.VideoOptions(encoder="nvenc"),)
El fotograma que dibuja una de esas funciones (su idioma, su tamaño, el
límite de color) también es un registro propio, simulation.AnimationFrame,
que se pasa como frame=. Un GIF se escribe siempre en la CPU.
Una animación que dibujas tú se codifica solo aquí: lo que viaja a un nodo es lo que la biblioteca puede volver a dibujar allí, las dos funciones que escriben simulaciones. Escribir animaciones y simulaciones FDTD en vídeo explica los contenedores, los códecs, los codificadores y los preajustes de calidad.
Qué elegir
Sección titulada «Qué elegir»- Una malla pequeña avanza igual de rápido con NumPy, o más: una GPU paga un coste fijo por cada operación que lanza, y solo una malla lo bastante grande lo amortiza.
- Una malla grande y una GPU de NVIDIA aquí:
Compute(device="cupy"). - Un Mac:
Compute(device="torch:mps", dtype="float32"), con la cota en float32 que publica la página sobre dónde se calcula una simulación. - Sin GPU aquí, pero con una en una máquina a la que llegas: el mismo
registro con
host=. - Un vídeo:
io.VideoOptions(encoder="auto"), el valor por defecto, aquí, o las funciones que escriben simulaciones con un host cuando el dibujo también deba hacerse junto a la GPU.
Qué cubre esta guía
Sección titulada «Qué cubre esta guía»Cubierto
El mapa de dónde se ejecuta el trabajo pesado de phonometry: los dispositivos en los que avanza una simulación, un nodo nombrado en el fichero de hosts y los codificadores de CPU y de GPU de un vídeo, aquí o en un nodo, con la página que explica cada uno.
No cubierto
Ejecutar código propio en un nodo: solo viajan las funciones de la biblioteca, con sus argumentos como datos. Codificar en un nodo una animación dibujada aquí. JAX y las demás bibliotecas de arrays. NVENC, Quick Sync, VAAPI y VideoToolbox se prueban y se usan, y no se comprueban en CI.