Consumo de recursos
Nada de lo publicado hasta ahora sobre este servidor decía lo que cuesta ejecutarlo. Esta página sí: memoria residente, tiempo de procesador, número de goroutines y latencia por método, medidos en ambos transportes y según los ajustes que de verdad mueven esas cifras.
Qué se mide
Sección titulada «Qué se mide»Seis ejes, elegidos porque son los que mueven las cifras:
| Eje | Valores | Por qué importa |
|---|---|---|
| Transporte | stdio, HTTP | stdio da a cada cliente su propio proceso; HTTP atiende a todos desde uno, con el estado de credencial agrupado por token y un catálogo construido por configuración |
| Superficie de herramientas | dynamic, meta, individual | La superficie dinámica registra dos herramientas y la individual cerca de mil |
| Clientes simultáneos | 8 procesos en stdio, 64 credenciales en HTTP | En HTTP el pool guarda una entrada por token, así que este es el eje por el que crece un despliegue compartido |
| Peticiones en paralelo | De 2 a 4 en vuelo por cliente | Separa el coste de tener clientes del coste de que todos llamen a la vez |
| Telemetría | desactivada, activada | Exportar es un trabajo que el servidor no haría de otro modo |
| Credenciales a escala | De 1 a 1000 en HTTP, una serie por superficie | Un despliegue compartido atiende a cientos de tokens; la serie mide la pendiente y el codo de latencia en lugar de multiplicar una cifra por token |
Cuatro métricas, tomadas del sistema operativo y de la red en lugar de desde dentro del programa:
- Conjunto residente, en mebibytes, en cuatro momentos: en reposo, con un cliente, con todos los clientes y en su pico bajo carga. Se lee del núcleo y no de la contabilidad de heap de Go, porque el conjunto residente es lo que mide el límite de un contenedor: las dos cifras difieren en más de un factor de dos, y solo una de ellas hace que maten un proceso.
- Tiempo de procesador, separado entre lo que costó construir las superficies y lo que costó atender las peticiones. La cifra de carga es un porcentaje de un núcleo, así que por encima del 100% había varios núcleos ocupados.
- Número de goroutines, en reposo, con todos los clientes conectados.
- Percentiles de latencia, por método MCP, desde el lado del cliente.
La serie de concurrencia registra, en cada número de credenciales: el conjunto
residente de la fase estable, como media y como pico; el heap vivo y el conjunto
residente en reposo, leídos una vez detenida esa fase; el tiempo de procesador
por llamada completada; el p50 y el p99 de tools/call y de tools/list; el
número de goroutines; los contadores del pool que conoce el controlador (las entradas
admitidas y la capacidad con la que dimensionó el pool); y un perfil de CPU y
otro de heap del servidor, guardados junto al registro para el análisis y no
versionados.
Cómo se ha medido
Sección titulada «Cómo se ha medido»El binario real, compilado desde la copia de trabajo actual y arrancado como
lo arranca un cliente, en ambos transportes. Un arnés que recompusiera el
servidor a partir de los mismos paquetes estaría informando sobre su propia
copia, y se perdería la puerta de disponibilidad, la cadena de autenticación, el
pool y el análisis de flags, que es casi todo lo que dimensiona un operador.
GitLab se sustituye por un servidor HTTP dentro del propio arnés, que responde a
los endpoints de versión y de usuario que el servidor consulta mientras
construye una entrada de pool y con 404 a las consultas de ámbitos y de tier,
que cualquier llamante lee como “esta instancia no lo dirá”. Una ejecución no
necesita por tanto instancia, ni credenciales, ni red, y dos personas que
repitan la medición comparan este servidor y no sus instalaciones de GitLab. El
colector OTLP se sustituye del mismo modo, así que los escenarios de telemetría
miden lo que cuesta exportar y no lo que un colector hace con la carga. La
superficie de herramientas se pasa de forma explícita en lugar de leerse del
entorno, para que una máquina de desarrollo y la integración continua midan lo
mismo, y del entorno que hereda un proceso medido se quitan todas las variables
que lee este servidor.
Unos cuantos detalles cambian lo que significan las cifras:
- El limitador de peticiones está desactivado (
--rate-limit-rps=0) en todos los escenarios de esta página. El modo HTTP usa por defecto diez peticiones por segundo, y un benchmark que lanza peticiones en paralelo se pasaría el tiempo recibiendo rechazos, así que una cifra de capacidad medida con él activo sería el coste de decir que no. Los rechazos son otra medición:test/e2e/httpcomprueba que ocurren, ymake bench-fairnessmide si ayudan a alguien, en un modo opcional que aquí no publica nada. - El arnés habla JSON-RPC directamente, no a través del SDK de Go. Desde el
protocolo 2026-07-28 un cliente puede servir
tools/listdesde su propia caché, y el cliente del SDK lo hace: medido a través de él, un listado que al servidor le cuesta cientos de milisegundos vuelve en microsegundos sin que ninguna petición salga del proceso. Lo que se publica aquí es el trabajo que hace el servidor; un cliente con caché lo paga menos veces, y nunca menos de una vez por sesión. - El protocolo 2026-07-28 no tiene handshake. Eliminó
initializeyping, así que lo primero que espera un cliente es su primera petición real, y las cifras de arranque se anclan en el primertools/list. - Los escenarios puntuales toman el número de goroutines de una señal de
traza. Arrancan el servidor sin su listener de perfiles, para que el proceso
sea el que ejecuta un operador, y la única forma de preguntar es
SIGQUITconGOTRACEBACK=all, que imprime la pila de cada goroutine y termina el proceso; es lo último que hace cada escenario. La serie lee el número de--pprof-addr, lo que deja vivo el proceso para el siguiente paso. - Los percentiles son de rango más cercano, así que cada percentil publicado es un valor que se observó de verdad y no uno interpolado entre dos que sí se observaron.
La sección Mediciones de más abajo la regenera una sola orden,
make bench-resources, que ejecuta el banco de pruebas y redibuja las gráficas
y las tablas a partir del registro que escribe; el texto que la rodea está
escrito a mano. La máquina, la compilación y el método aparecen en el texto bajo
el encabezado, y cada gráfica repite en su borde inferior la parte de eso sin la
que no puede leerse fuera de esta página: cuántas CPU lógicas midieron, en qué
sistema operativo y con qué núcleo, y cuándo.
Esta página es una instantánea, y solo eso. Una medición nueva en la máquina de referencia sustituye estos valores por completo: sin columna de “antes”, sin proporción frente a una ejecución anterior, sin histórico. Una cifra comparada con una ejecución cuyo código ya no existe no dice nada sobre la instancia que estás dimensionando. Lo que cambió entre mediciones, y por qué, está en Resource Hot Spots, y para qué sirvió cada cambio, en su ADR.
Los escenarios puntuales ejecutan 64 credenciales en HTTP y 8 procesos en
stdio, admitiéndolos de uno en uno y cargándolos después todos a la vez. 64
queda muy por encima del punto en que la máquina se satura y por debajo del
límite por defecto del pool, que es 100, así que el escenario ejecuta la
configuración que se distribuye y mide contención real; un escenario puntual no
pasa ningún flag del pool, y nada de lo que admite se desaloja antes de medirse.
8 en stdio, porque cada uno es un proceso entero con su propio catálogo y ocho
clientes simultáneos son una máquina de desarrollo ocupada. Los escenarios
puntuales no se meten en el terreno de la serie: de una a mil credenciales es
la pregunta de la serie, y ellos existen para los ejes que la serie no mide en
absoluto, que son stdio, la telemetría, la latencia de resources/list, el
número de goroutines de un proceso sin listener de perfiles y la propia rampa
en serie.
Un despliegue compartido atiende a cientos, así que el banco de pruebas ejecuta
además una serie de concurrencia por superficie: un solo proceso HTTP al
que se le dan por turnos 1, 2, 5, 10, 20, 50, 100, 200, 500 y 1000 credenciales
distintas, cada una calentada con un tools/list, y que se mide en cada
recuento durante una fase estable de diez segundos en la que todas las
credenciales llaman sin parar a tools/call y tools/list. Cada paso
registra la memoria residente (media y pico), el tiempo de procesador por
llamada, el p50 y el p99 de ambos métodos y el número de goroutines, y captura
un perfil de CPU y otro de heap del servidor a través de su listener
--pprof-addr, que el análisis lee y el sitio no publica.
El proceso de la serie arranca con --pprof-addr en un puerto de loopback que
elige el controlador y con --max-http-clients igual al recuento más alto, para que
nada de lo que admitió un paso se desaloje antes de que el siguiente lo mida.
-clients sustituye la lista de recuentos, y -quick usa 1, 2 y 5. En cada
recuento, el controlador:
- Admite las credenciales nuevas, de ocho en ocho, cada una calentada con
un
tools/listen frío para que el pool tenga una entrada construida para ella. - Ejecuta una fase estable de diez segundos (
-step-duration) en la que cada credencial mantiene en vuelo el paralelismo del escenario, y cada trabajador alternatools/callytools/list. Una duración fija y no un número fijo de llamadas, porque un perfil de CPU se toma sobre segundos de reloj y un número que tardaba segundos con una credencial tardaría un tiempo sin límite en cuanto se degrada la latencia, que es justo la zona a la que la serie existe para llegar. Cada cifra por llamada divide entre las llamadas que de verdad se completaron. - Perfila el servidor mientras atiende: un perfil de CPU sobre el primer
80% de la fase y, al terminar la fase, un perfil de heap tomado tras una
recolección y el total de goroutines. Los perfiles quedan en
bench/profiles/<scenario>/<clients>.cpu.pb.gzy<clients>.heap.pb.gz(-profiles), que git ignora. - Toma una lectura en reposo: detenida la carga, se deja el proceso solo
medio segundo, se fuerza una recolección y se lee el heap vivo con el
conjunto residente al lado. Es la misma medición que hace en cada push la
prueba de extremo a extremo
TestSharedServer_LiveHeapDoesNotGrowWithTheNumberOfCredentials, tomada aquí en cada paso de la escalera.
La telemetría se queda desactivada durante la serie, así que mide el mismo servidor que los escenarios puntuales.
Cada paso se mide además una segunda vez, con la carga detenida. Las dos lecturas responden a preguntas distintas: el conjunto residente de la fase estable es lo que cuestan N credenciales mientras todas están llamando, y la lectura en reposo, tomada al terminar la carga y forzando una recolección, es lo que cuesta mantenerlas. La primera se mide en megabytes por credencial y la segunda en kilobytes, así que ninguna sustituye a la otra. El conjunto residente en reposo se registra junto al heap en reposo y va por detrás de él, porque liberar el montículo no devuelve las páginas: el recolector de Go las devuelve según su propio calendario.
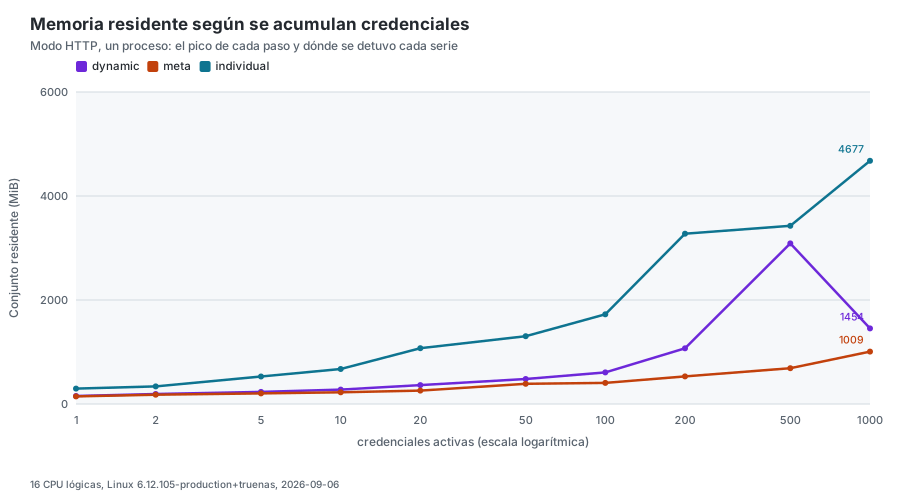
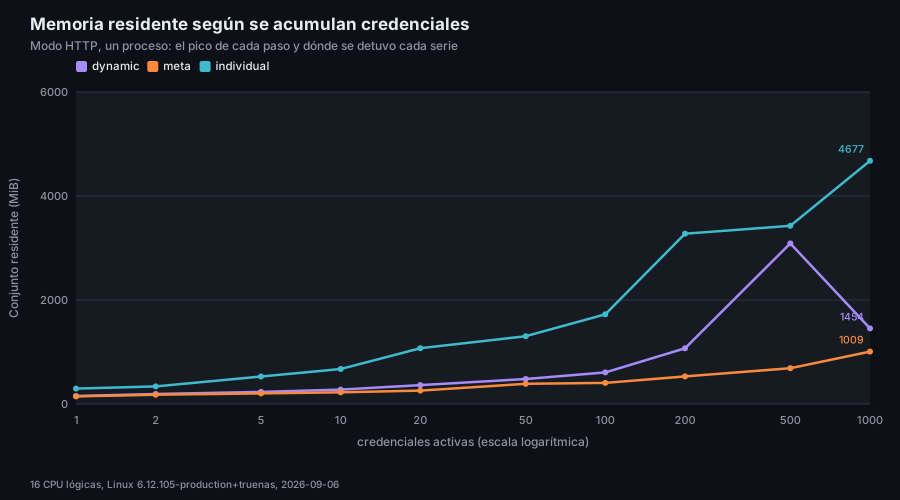
En la máquina de referencia las dos lecturas no se parecen. Con mil credenciales
en la superficie dinámica, el pico de conjunto residente fue de 1454 MiB frente
a un heap vivo en reposo de 88,3 MiB, un factor de dieciséis. Los perfiles de
heap dicen de qué está hecha la diferencia, comparando el primer paso con el
último. En dynamic las entradas que construyen el catálogo no se mueven:
toolutil.cloneSchemaMap ocupa 10,0 MiB con una credencial y 10,0 MiB con mil,
y lo mismo el índice de búsqueda, el catálogo de acciones y los mapas de
esquemas que hay debajo. Lo que crece son las conexiones y las credenciales: el
lector y el escritor bufio de cada socket abierto, ausentes del perfil con una
credencial y 35,6 MiB repartidos entre los cuatro mil que había en el último
paso, y el cliente de GitLab de cada entrada del pool, 5,0 MiB entre mil de
ellas. El resto de la diferencia nunca llega a la cifra en reposo, porque es el
JSON de las llamadas que estaban en vuelo cuando se detuvo la carga.
Una serie se detiene antes de tumbar la máquina: antes de cada paso se estima, a
partir de los anteriores, la memoria residente que alcanzaría, con una recta
ajustada a sus picos (con un solo paso del que partir, la extrapolación es
proporcional, lo que tiende a parar antes), y el resto de la lista se omite
cuando la estimación supera el presupuesto de memoria: -memory-budget, en
MiB, o el 80% de la memoria disponible del equipo (MemAvailable en
/proc/meminfo) leída al empezar la ejecución. Un equipo que no la informa se
ejecuta sin presupuesto, y la serie lo dice. Un paso cuyo p99 de tools/call
pase de 30 segundos es el último que se ejecuta, porque a partir de ahí un
cliente se ha rendido y el siguiente paso mediría tiempos de espera y no el
servidor. Dónde se detuvo cada serie, y por qué, se indica bajo su tabla. En la
ejecución publicada aquí no se detuvo ninguna: las tres llegaron a mil
credenciales.
Mediciones
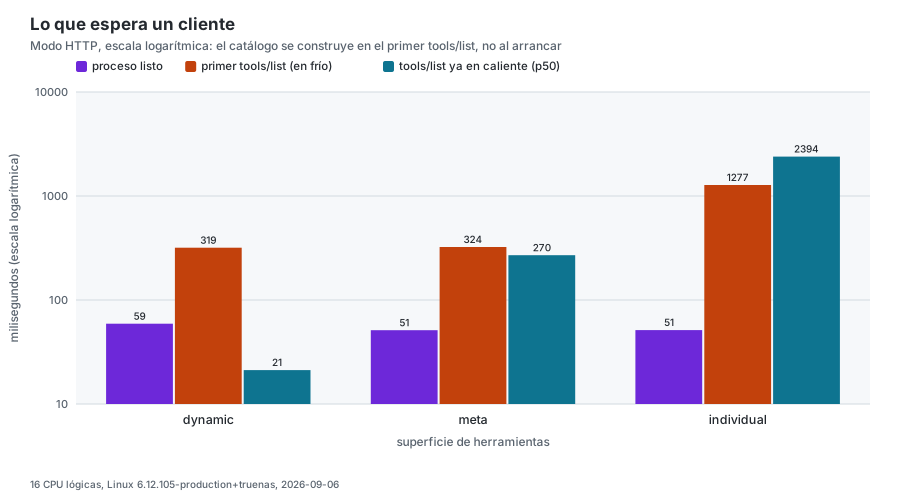
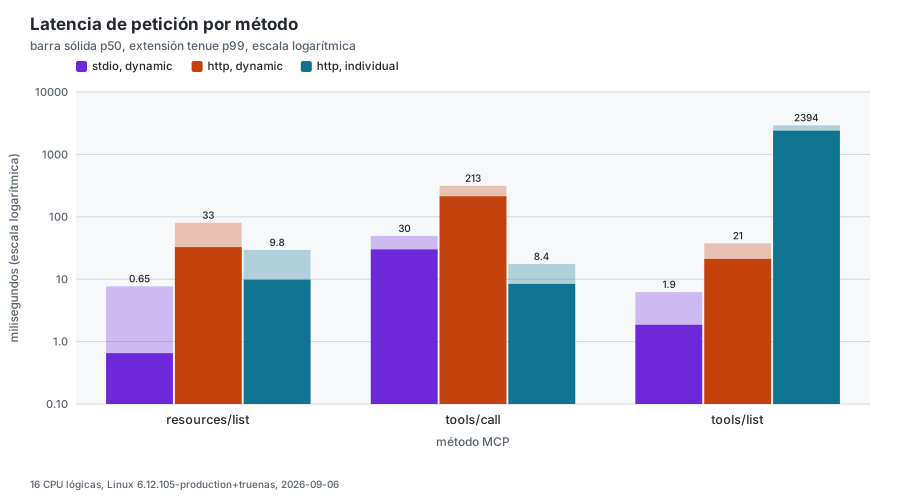
Sección titulada «Mediciones»Medido en Intel(R) Core(TM) i5-14400, 16 CPU lógicas, 62 GiB de RAM, linux/amd64, núcleo 6.12.105-production+truenas, go1.27.1, compilación 2.7.6-0.20260906081503-18bed59da189 (18bed59d), 2026-09-06T08:24:43Z. 3 rondas por método, conjunto residente muestreado cada 100 ms.
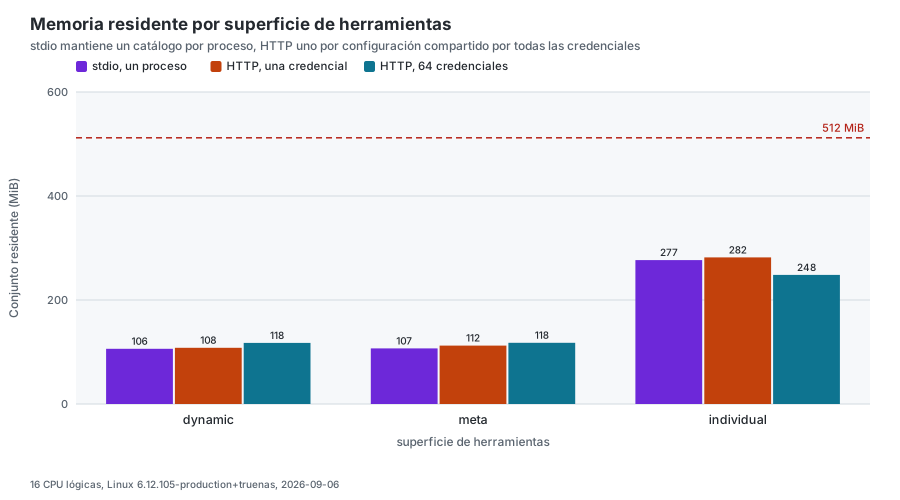
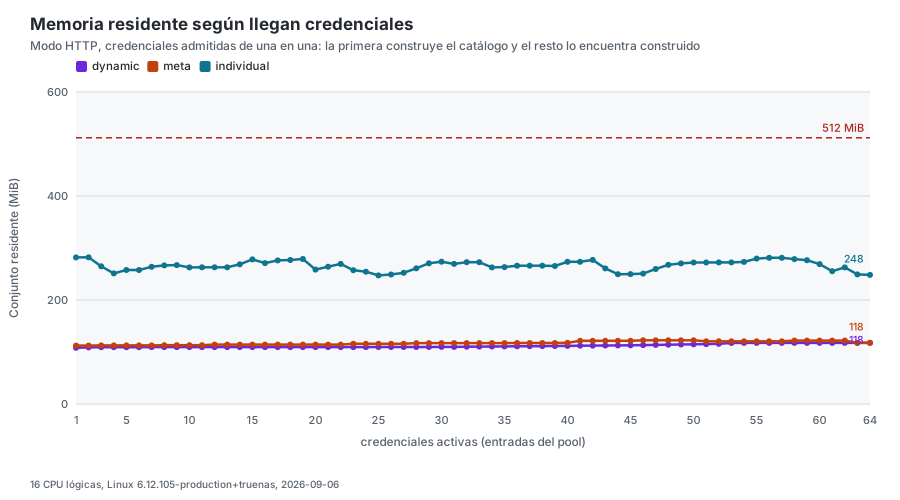
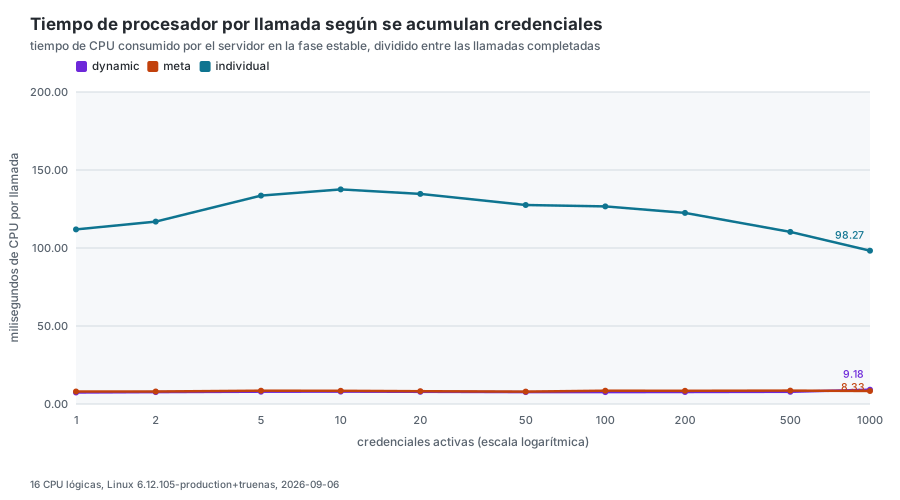
Memoria, goroutines y tiempo de procesador por escenario
Sección titulada «Memoria, goroutines y tiempo de procesador por escenario»| Escenario | Clientes | En reposo | Un cliente | Todos los clientes | Por cliente extra | Pico | Goroutines | CPU, % de un núcleo |
|---|---|---|---|---|---|---|---|---|
| stdio, dynamic | 8 | n/a | 106 | 849 | 106 | 995 | 34 | 1039% |
| stdio, meta | 8 | n/a | 107 | 857 | 107 | 1018 | 36 | 794% |
| stdio, individual | 8 | n/a | 277 | 2134 | 265 | 2291 | 36 | 1120% |
| stdio, dynamic, telemetry | 8 | n/a | 111 | 893 | 112 | 1048 | 43 | 1080% |
| http, dynamic | 64 | 35 | 108 | 118 | 0 | 375 | 291 | 974% |
| http, meta | 64 | 37 | 112 | 118 | 0 | 324 | 293 | 928% |
| http, individual | 64 | 36 | 282 | 248 | -1 | 1422 | 165 | 1147% |
| http, dynamic, telemetry | 64 | 38 | 113 | 122 | 0 | 383 | 300 | 1018% |
Lo que espera un cliente, por escenario
Sección titulada «Lo que espera un cliente, por escenario»| Escenario | Proceso listo | Primer tools/list | tools/list en caliente (p50) | Tamaño de tools/list |
|---|---|---|---|---|
| stdio, dynamic | 0.26 | 351 | 1.9 | 12 KB |
| stdio, meta | 0.17 | 341 | 42 | 598 KB |
| stdio, individual | 0.18 | 1279 | 379 | 3.2 MB |
| stdio, dynamic, telemetry | 0.24 | 333 | 1.7 | 12 KB |
| http, dynamic | 59 | 319 | 21 | 12 KB |
| http, meta | 51 | 324 | 270 | 599 KB |
| http, individual | 51 | 1277 | 2394 | 3.2 MB |
| http, dynamic, telemetry | 51 | 319 | 20 | 12 KB |
Percentiles de latencia por método
Sección titulada «Percentiles de latencia por método»| Escenario | Método | Llamada | p50 | p90 | p99 | Máx |
|---|---|---|---|---|---|---|
| stdio, dynamic | resources/list | el listado más pequeño | 0.65 | 7.6 | 7.7 | 7.7 |
| stdio, dynamic | tools/call | gitlab_find_action | 30 | 41 | 49 | 49 |
| stdio, dynamic | tools/list | la superficie completa | 1.9 | 6.0 | 6.2 | 6.2 |
| stdio, meta | resources/list | el listado más pequeño | 0.64 | 0.99 | 1.2 | 1.2 |
| stdio, meta | tools/call | gitlab_server (status) | 1.7 | 40 | 41 | 41 |
| stdio, meta | tools/list | la superficie completa | 42 | 51 | 55 | 55 |
| stdio, individual | resources/list | el listado más pequeño | 0.57 | 0.78 | 0.93 | 0.93 |
| stdio, individual | tools/call | gitlab_server_status | 0.87 | 1.4 | 1.8 | 1.8 |
| stdio, individual | tools/list | la superficie completa | 379 | 405 | 424 | 424 |
| stdio, dynamic, telemetry | resources/list | el listado más pequeño | 0.79 | 0.87 | 0.95 | 0.95 |
| stdio, dynamic, telemetry | tools/call | gitlab_find_action | 30 | 47 | 50 | 50 |
| stdio, dynamic, telemetry | tools/list | la superficie completa | 1.7 | 2.3 | 2.6 | 2.6 |
| http, dynamic | resources/list | el listado más pequeño | 33 | 48 | 80 | 85 |
| http, dynamic | tools/call | gitlab_find_action | 213 | 307 | 314 | 314 |
| http, dynamic | tools/list | la superficie completa | 21 | 35 | 38 | 38 |
| http, meta | resources/list | el listado más pequeño | 10 | 55 | 62 | 66 |
| http, meta | tools/call | gitlab_server (status) | 23 | 31 | 33 | 34 |
| http, meta | tools/list | la superficie completa | 270 | 388 | 403 | 404 |
| http, individual | resources/list | el listado más pequeño | 9.8 | 13 | 30 | 30 |
| http, individual | tools/call | gitlab_server_status | 8.4 | 16 | 18 | 18 |
| http, individual | tools/list | la superficie completa | 2394 | 2855 | 2929 | 2949 |
| http, dynamic, telemetry | resources/list | el listado más pequeño | 14 | 53 | 59 | 61 |
| http, dynamic, telemetry | tools/call | gitlab_find_action | 213 | 301 | 314 | 315 |
| http, dynamic, telemetry | tools/list | la superficie completa | 20 | 35 | 36 | 37 |
Serie de concurrencia
Sección titulada «Serie de concurrencia»http, superficie dynamic: 4 en vuelo por credencial, 10 s por paso
Sección titulada «http, superficie dynamic: 4 en vuelo por credencial, 10 s por paso»| Credenciales | Residente, media | Residente, pico | Heap en reposo | Residente en reposo | CPU por llamada | Llamadas | tools/call p50 | tools/call p99 | tools/list p50 | tools/list p99 | Goroutines |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 143 | 154 | 39.0 | 106 | 7.394 | 6895 | 11 | 14 | 0.96 | 3.4 | 18 |
| 2 | 172 | 192 | 39.1 | 107 | 7.633 | 11070 | 13 | 18 | 1.1 | 4.7 | 22 |
| 5 | 217 | 232 | 39.2 | 109 | 7.910 | 13684 | 23 | 43 | 3.9 | 16 | 36 |
| 10 | 241 | 277 | 39.5 | 110 | 7.971 | 13660 | 43 | 118 | 7.5 | 53 | 56 |
| 20 | 289 | 364 | 40.0 | 115 | 7.843 | 14254 | 75 | 274 | 11 | 147 | 96 |
| 50 | 414 | 481 | 41.5 | 122 | 7.629 | 16777 | 151 | 766 | 11 | 471 | 216 |
| 100 | 547 | 608 | 44.0 | 133 | 7.639 | 17482 | 269 | 1578 | 15 | 956 | 416 |
| 200 | 869 | 1070 | 48.9 | 157 | 7.674 | 17851 | 406 | 3572 | 20 | 1757 | 816 |
| 500 | 1958 | 3089 | 64.0 | 232 | 7.851 | 17187 | 911 | 9313 | 52 | 4188 | 2015 |
| 1000 | 897 | 1454 | 88.3 | 288 | 9.176 | 16119 | 3106 | 8857 | 2216 | 6357 | 4015 |
Ajustado sobre estos pasos: el pico de conjunto residente bajo carga crece 1.92 MiB por credencial, y el heap vivo en reposo, leído con la carga detenida y una recolección forzada, crece 50.6 KiB por credencial. Lo primero es lo que cuesta una credencial mientras ella y todas las demás están llamando; lo segundo es lo que cuesta mantenerla. El conjunto residente en reposo va por detrás de ambos, porque Go devuelve al sistema operativo las páginas liberadas según su propio calendario. Se ejecutaron todos los pasos previstos, hasta 1000 credenciales.
http, superficie meta: 4 en vuelo por credencial, 10 s por paso
Sección titulada «http, superficie meta: 4 en vuelo por credencial, 10 s por paso»| Credenciales | Residente, media | Residente, pico | Heap en reposo | Residente en reposo | CPU por llamada | Llamadas | tools/call p50 | tools/call p99 | tools/list p50 | tools/list p99 | Goroutines |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 134 | 146 | 32.6 | 93.0 | 8.014 | 6323 | 0.97 | 4.0 | 11 | 16 | 20 |
| 2 | 162 | 179 | 32.7 | 94.7 | 8.001 | 9544 | 1.4 | 5.3 | 15 | 20 | 24 |
| 5 | 185 | 203 | 32.8 | 94.7 | 8.512 | 10810 | 6.9 | 20 | 29 | 49 | 36 |
| 10 | 199 | 226 | 33.1 | 96.0 | 8.489 | 11025 | 16 | 53 | 51 | 117 | 56 |
| 20 | 232 | 257 | 33.6 | 100 | 8.234 | 11486 | 34 | 146 | 91 | 247 | 96 |
| 50 | 298 | 388 | 35.2 | 107 | 7.953 | 12021 | 138 | 451 | 165 | 530 | 216 |
| 100 | 295 | 406 | 37.9 | 116 | 8.517 | 11842 | 349 | 775 | 348 | 700 | 416 |
| 200 | 376 | 531 | 43.2 | 135 | 8.458 | 12427 | 747 | 1481 | 648 | 1250 | 816 |
| 500 | 514 | 689 | 59.5 | 184 | 8.599 | 14008 | 1414 | 3252 | 1763 | 3077 | 2015 |
| 1000 | 749 | 1009 | 83.5 | 243 | 8.330 | 16130 | 1791 | 6808 | 3180 | 6028 | 4015 |
Ajustado sobre estos pasos: el pico de conjunto residente bajo carga crece 0.81 MiB por credencial, y el heap vivo en reposo, leído con la carga detenida y una recolección forzada, crece 52.6 KiB por credencial. Lo primero es lo que cuesta una credencial mientras ella y todas las demás están llamando; lo segundo es lo que cuesta mantenerla. El conjunto residente en reposo va por detrás de ambos, porque Go devuelve al sistema operativo las páginas liberadas según su propio calendario. Se ejecutaron todos los pasos previstos, hasta 1000 credenciales.
http, superficie individual: 2 en vuelo por credencial, 10 s por paso
Sección titulada «http, superficie individual: 2 en vuelo por credencial, 10 s por paso»| Credenciales | Residente, media | Residente, pico | Heap en reposo | Residente en reposo | CPU por llamada | Llamadas | tools/call p50 | tools/call p99 | tools/list p50 | tools/list p99 | Goroutines |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 273 | 296 | 88.1 | 186 | 111.908 | 262 | 1.1 | 4.9 | 151 | 268 | 18 |
| 2 | 296 | 338 | 88.3 | 183 | 116.938 | 480 | 1.1 | 6.9 | 164 | 201 | 20 |
| 5 | 429 | 530 | 88.4 | 191 | 133.564 | 766 | 1.3 | 11 | 262 | 291 | 26 |
| 10 | 538 | 673 | 88.5 | 194 | 137.591 | 855 | 17 | 61 | 454 | 593 | 36 |
| 20 | 731 | 1073 | 88.8 | 200 | 134.659 | 953 | 38 | 257 | 784 | 1319 | 56 |
| 50 | 1081 | 1303 | 89.7 | 211 | 127.568 | 1110 | 68 | 804 | 1685 | 3502 | 116 |
| 100 | 1266 | 1724 | 91.1 | 215 | 126.672 | 1292 | 213 | 2572 | 2828 | 7144 | 216 |
| 200 | 2244 | 3274 | 94.0 | 248 | 122.502 | 1499 | 239 | 3428 | 5430 | 12328 | 415 |
| 500 | 2522 | 3427 | 103 | 277 | 110.330 | 2361 | 285 | 11643 | 11082 | 18163 | 1015 |
| 1000 | 3330 | 4677 | 117 | 326 | 98.265 | 3637 | 4974 | 16559 | 16796 | 25229 | 2015 |
Ajustado sobre estos pasos: el pico de conjunto residente bajo carga crece 4.27 MiB por credencial, y el heap vivo en reposo, leído con la carga detenida y una recolección forzada, crece 29.8 KiB por credencial. Lo primero es lo que cuesta una credencial mientras ella y todas las demás están llamando; lo segundo es lo que cuesta mantenerla. El conjunto residente en reposo va por detrás de ambos, porque Go devuelve al sistema operativo las páginas liberadas según su propio calendario. Se ejecutaron todos los pasos previstos, hasta 1000 credenciales.
Dimensionar un despliegue
Sección titulada «Dimensionar un despliegue»stdio. Un proceso por cliente, y el proceso empieza a construir su catálogo nada más arrancar, así que no hay ningún estado de reposo en el que ahorrar memoria. Entre 106 y 277 MiB por proceso según la superficie, con picos algo mayores bajo carga. Entre procesos no se comparte nada, así que el coste es una línea recta en el número de clientes: una máquina de desarrollo con un solo cliente no lo notará, y la columna “todos los clientes” es lo que pesan ocho juntos.
HTTP. Parte de entre 35 y 38 MiB para un proceso que no atiende a nadie y
suma un catálogo por cada configuración distinta, que construye la primera
credencial que lo pide y comparten todas las demás credenciales de esa misma
configuración: el servidor se construye una vez por forma de configuración
(ADR-0020),
así que lo que guarda una credencial es su cliente, su cubo de límite de
peticiones, su contador de listen y sus watchers. Eso es lo que informa la
columna “por cliente extra”: 0,15, 0,09
y -0,53 MiB en dynamic, meta e individual, es decir, nada por encima del
ruido de una lectura de conjunto residente, a lo largo de una escalera que
admite 64 credenciales de una en una. Lo que queda por dimensionar es el
trabajo concurrente, que es la columna de pico contigua: de 324 a 1422 MiB con
las 64 llamando.
Hay dos ejes, y solo uno de ellos es el pool. Mantener una credencial
cuesta 50,6 KiB de heap vivo en reposo en dynamic, 52,6 KiB en meta y 29,8
KiB en individual, de modo que mil credenciales admitidas añaden 49, 51 y 29
MiB, para un heap vivo en reposo de 88,3, 83,5 y 117,4 MiB y un conjunto
residente en reposo de 0,28, 0,24 y 0,32 GiB.
Servirlas es donde una instancia se queda sin memoria: con todas manteniendo
entre dos y cuatro peticiones en vuelo, el pico de conjunto residente crece
1,92, 0,81 y 4,27 MiB por credencial, y en el paso de mil credenciales se situó
en 1,4, 1,0 y 4,6 GiB.
Una regla práctica para HTTP: reserva entre 1 y 4 MiB, según la superficie,
por llamante simultáneo, más 40 MiB para el proceso y un catálogo por
configuración. --max-http-clients acota las credenciales del pool y no es
un ajuste de memoria: a 50 KiB cada una, su valor por defecto de 100 son cinco
mebibytes. Acorta --pool-idle-timeout si quieres que las entradas se
recuperen antes, pero espera recuperar kilobytes, no gigabytes: lo que ese
tiempo de espera sigue acotando son los clientes de GitLab vivos y los watchers
que guarda una entrada.
No hay suelo, solo un número de clientes. “Con 512 MiB basta” es la forma de consejo que esta página no puede dar por sí sola, porque cualquier cifra fija lleva escondido un número de credenciales llamando a la vez. Lee la columna de pico del escenario o del paso de la serie que corresponda a tu superficie y a la concurrencia que esperas, y dale al contenedor eso más un margen para las páginas que Go todavía no ha devuelto. Dimensionar un despliegue hace esa cuenta para veinte, cien y mil llamantes a la vez.
Rendimiento. En la serie, las llamadas completadas por escalón de diez
segundos suben deprisa hasta unas cinco credenciales en dynamic y meta y
despacio después: una llamada cuesta unos 8 ms de tiempo de procesador, así que
el techo lo ponen los hilos de la máquina. En dynamic el escalón completa
13.684 llamadas con cinco credenciales, unas 1.370 por segundo, y de 16.777 a
17.851 entre cincuenta y doscientas, aproximadamente de 1.700 a 1.800 por
segundo, que con 7,6 a 7,7 ms por llamada ocupan unos trece o catorce de los
dieciséis hilos; en meta completa 10.810 con cinco y de 11.000 a 12.400 de
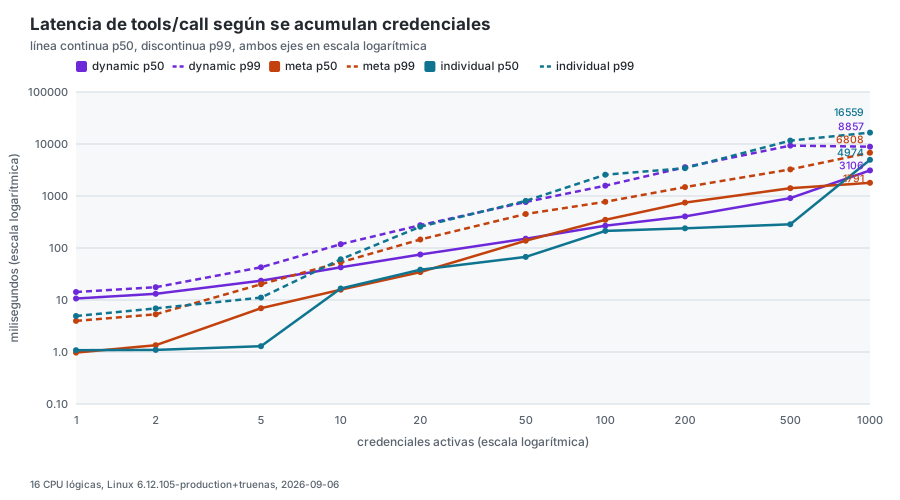
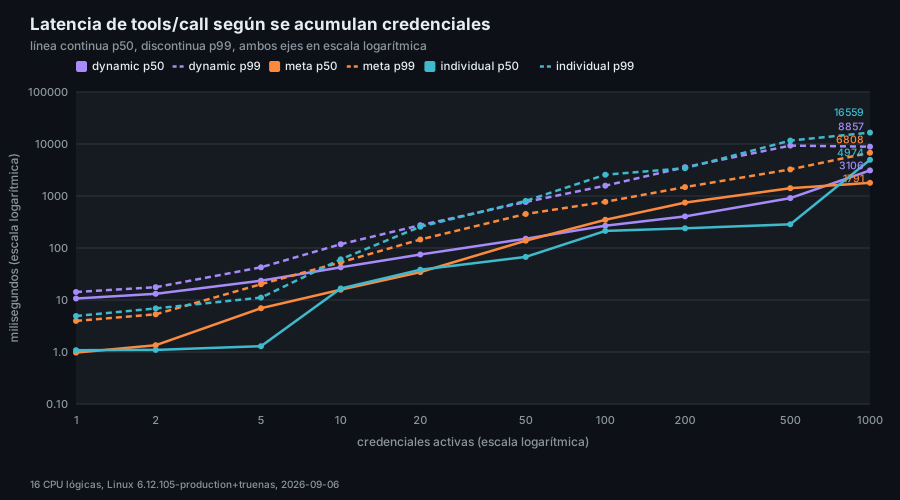
diez a doscientas. A partir de ahí la latencia es cola, con la p50 de
tools/call en dynamic subiendo de 11 ms con una credencial a 269 ms con
cien y a 3,1 segundos con mil. individual tiene otra forma: un tools/call cuesta ahí un
milisegundo, pero una llamada promedia 120 ms de tiempo de procesador, porque
una de cada dos es un tools/list que serializa tres megabytes de esquemas,
así que una sola credencial con dos peticiones en vuelo ya mantiene ocupados
tres núcleos, y la p50 de su tools/list es de 151 ms antes de que exista
contención alguna.
Un paso en lo alto de la escalera dura más que sus diez segundos, algo que
conviene saber antes de dividir el número de llamadas entre la duración del
paso. Un trabajador termina la llamada que tiene en vuelo en lugar de
abandonarla, y en los últimos pasos una llamada tarda decenas de segundos:
individual con mil credenciales completó 3.637 llamadas a 98,3 ms de tiempo de
procesador cada una, que son 357 segundos de núcleo y no caben en diez segundos
de una máquina de dieciséis hilos. Las cifras por llamada son correctas, porque
los dos lados de la división salen de la misma ventana; la ventana simplemente
es más larga que la duración que nombra el paso.
Adónde va la memoria que crece con el número de credenciales, leído de los perfiles de heap y de CPU que escribe la serie, se analiza en Resource Hot Spots, que guarda además el histórico que esta página no guarda.
Qué espera un cliente
Sección titulada «Qué espera un cliente»El proceso está listo en milisegundos y la superficie que hay detrás no. En
HTTP, /health responde entre 51 y 59 ms mientras el pool está vacío; la
primera credencial de una configuración construye su catálogo, y ahí está la
espera: 0,32 segundos en dynamic, 0,32 en meta y 1,28 en individual en la
máquina medida. En stdio el proceso se ejecuta en mucho menos de un milisegundo
y empieza a construir de inmediato, así que su primera petición espera ese
mismo trabajo: 0,35, 0,34 y 1,28 segundos.
Esa espera es por configuración y no por credencial, porque el servidor
construido se comparte, y se paga una vez por configuración mientras vive el
proceso: el servidor de una configuración solo se descarta cuando falla su
registro
(ADR-0020,
NEG-004), nunca porque se hayan recuperado sus entradas. Una credencial que
llega después de que --pool-idle-timeout o el límite de tamaño del pool se
llevaran su entrada solo paga la construcción de su propia entrada, la sonda de
la credencial, el nivel y los ámbitos, y después un listado en caliente. Dos
consecuencias: un cliente que se rinde antes de que responda su primera llamada
no se ha topado con un servidor colgado, y un despliegue HTTP paga la espera
una vez por configuración, no una vez por cada entrada recuperada.
Ya en caliente la imagen se invierte. Un tools/list cuesta entre 1,9 y 21 ms
en dynamic, entre 42 y 270 ms en meta y entre 0,38 y 2,4 segundos en
individual, que es lo que cuesta serializar 12 KB, 599 KB y 3,2 MB
respectivamente, siendo el extremo alto de cada par HTTP con las 64
credenciales llamando. Un cliente que hable el protocolo 2026-07-28 puede servir los
listados repetidos desde su propia caché y pagarlo menos veces, pero lo paga
al menos una vez por sesión.
Telemetría
Sección titulada «Telemetría»Exportar por OTLP cuesta unas pocas goroutines y tiempo de procesador medible, y nada de memoria apreciable. Viene desactivada por defecto; en OpenTelemetry está qué exporta y adónde va.
Lo que esto no mide
Sección titulada «Lo que esto no mide»- Un GitLab real. Cada llamada a herramienta que se responde aquí se responde por loopback, así que las cifras de latencia son la sobrecarga del propio servidor sin la aportación de la instancia. Súmales el tiempo de ida y vuelta de tu instancia.
- La caché de un cliente. La latencia publicada de
tools/listes lo que gasta el servidor, no lo que espera un cliente 2026-07-28 en una llamada repetida. - Nada que no sea esta máquina. Un host, un sistema operativo, una cadena de herramientas de Go, todos nombrados en el texto generado de arriba. La forma de las cifras debería trasladarse a otras máquinas; los valores absolutos no.
- Disco y red. Nada escribe en disco en el camino crítico, y la única red es loopback.
- Desalojos del pool. La serie dimensiona el pool a su paso más grande, así
que no hay ninguno, y los contadores que registra lo dicen por construcción.
Lo que cuesta una entrada desalojada y reconstruida es el
tools/listen frío que mide la rampa. - La carga del propio controlador. El controlador y el servidor comparten la máquina, y con mil credenciales el controlador lee miles de respuestas por segundo. Las cifras del servidor son suyas (el conjunto residente y el tiempo de procesador se leen por proceso), pero las latencias incluyen lo que el controlador haya añadido al estar ocupado.
Reproducirlo
Sección titulada «Reproducirlo»make bench-resources # medir y redibujarlo todomake bench-resources-render # redibujar desde el registro, sin medirmake check-bench-resources # comprobar que las gráficas y las tablas cuadran con el registroLos ocho escenarios puntuales tardan entre cinco y diez minutos en la máquina de referencia: la mitad stdio se va casi entera en construir un catálogo por proceso, que es justo el coste que se está midiendo y no una sobrecarga del arnés, y la mitad HTTP se va en servir 64 credenciales a la vez. Las series tardan después lo que la memoria del equipo les permita, hasta un cuarto de hora por superficie donde caben mil credenciales, menos donde el presupuesto las detiene antes. Para una comprobación más rápida mientras cambias el propio arnés, mide una matriz de humo en un registro propio sin dibujar nada:
go run ./cmd/bench_resources/ -quick -json /tmp/bench.json \ -profiles /tmp/bench-profiles -no-renderUna matriz parcial se niega a escribir en el registro publicado: sustituir
cifras medidas por una prueba de humo dejaría la documentación presentándolas
como las cifras. Una lista -clients propia es parcial por la misma razón.
Medir en un equipo y dibujar en otro
Sección titulada «Medir en un equipo y dibujar en otro»La serie con 500 y 1000 credenciales necesita decenas de gigabytes, y esa no siempre es la máquina en la que se escribe la documentación. El controlador tiene por eso un modo de solo medición que no lee nada del repositorio. Compila los dos binarios en una copia del repositorio, cópialos al equipo que tiene la memoria y ejecuta:
go build -o dist/bench_resources ./cmd/bench_resourcesgo build -o dist/gitlab-mcp-server ./cmd/server
# En el equipo de medición, sin cadena de herramientas de Go ni copia del repositorio:./bench_resources -binary ./gitlab-mcp-server \  -json /var/tmp/bench/resource-benchmark.json \  -profiles /var/tmp/bench/profiles \  -no-render
Después copia el registro sobre site/src/data/resource-benchmark.json y
redibuja a partir de él con make bench-resources-render; los perfiles se
quedan en el equipo de medición, o junto al registro en bench/profiles/, que
git ignora. Dos cosas sobre el equipo de medición: el controlador y el servidor
mantienen cada uno un socket por petición en vuelo, así que con mil credenciales
y cuatro en vuelo cada una el límite de ficheros abiertos tiene que admitir
varios miles de descriptores (Go sube por su cuenta el límite blando hasta el
duro, así que la cifra que hay que comprobar es ulimit -Hn); y el presupuesto
se lee de la memoria disponible del equipo al empezar la ejecución, así que
detén antes lo que la esté usando, o pasa -memory-budget de forma explícita.
El modo de llamadas retenidas
Sección titulada «El modo de llamadas retenidas»-held <counts> mide la otra forma de petición: la que el servidor mantiene
abierta porque GitLab no ha respondido. Es la medición con la que se dimensionó
el
techo de llamadas retenidas.
Todos los demás modos lanzan peticiones que el servidor responde tan rápido como
puede, así que ninguno ve lo que cuesta una llamada retenida ni lo que hace un
proceso que retiene demasiadas. El GitLab sustituto retiene cada lectura de
proyecto que le envía un paso, cabeceras primero (el servidor le da a GitLab un
minuto para responder con cabeceras, y abandonaría y reenviaría una lectura
retenida antes de ellas), así que cada paso es un número conocido de llamadas al
gitlab_execute_action de la superficie dinámica que ejecutan project.get,
repartidas por turnos entre -held-credentials, retenidas a la vez y
muestreadas mientras lo están.
Un paso se muestrea en cuanto cada llamada que ofreció está retenida en el
sustituto o ha vuelto, o en cuanto ese recuento lleva tres segundos sin moverse
(un proceso sin descriptores no acepta más conexiones, así que algunas llamadas
no están en ningún sitio), o al cabo de dos minutos. La muestra son los
descriptores abiertos del proceso (solo en Linux, de /proc/<pid>/fd; en otros
sistemas se registran como desconocidos con una nota), sus goroutines y su heap
vivo según el listener de perfiles, su conjunto residente y una consulta a
/health por una conexión propia, porque una consulta que viajara por una
conexión keep-alive antigua respondería por un proceso que ya no acepta
ninguna. Después cada paso libera la retención y clasifica cada llamada como
atendida, rechazada (un 503, el estado con el que el techo de llamadas
retenidas responde a un cliente 2026-07-28, conservando su primer texto) o
fallida, y pone precio a una llamada retenida como el crecimiento del paso sobre
el proceso en reposo dividido entre las llamadas retenidas.
-held-nofile <n> arranca el servidor a través de
/bin/sh -c 'ulimit -n "$0" && exec "$@"', que fija a la vez el límite blando y
el duro y pone el servidor en el lugar del shell, así que el proceso muestreado
es el servidor. Fijar el límite duro es la clave: el runtime de Go sube el
blando hasta el duro antes de que arranque el servidor, así que bajar solo el
blando no mediría nada. El servidor dimensiona su techo de llamadas retenidas a
partir de ese límite, 192 bajo 1024. El modo escribe bench/held.json, que no
se versiona, no dibuja nada y se rechaza si -held-json nombra el registro
publicado. make bench-held ejecuta la escalera con la que se midió el techo,
bajo un límite de 1024.
| Flag | Tipo | Por defecto | Descripción |
|---|---|---|---|
-held | string | "" | Recuentos de llamadas retenidas a la vez, separados por comas y en orden ascendente; vacío ejecuta la matriz |
-held-credentials | int | 1 | Credenciales entre las que se reparten las llamadas |
-held-nofile | int | 0 | Límite de descriptores con el que arranca el servidor; 0 hereda el de este proceso (no en Windows) |
-held-json | string | bench/held.json | Documento que se escribe; se rechaza si nombra el registro publicado |
# Lo que cuesta una llamada retenida, y lo que hace el proceso pasado un límite de descriptoresgo run ./cmd/bench_resources/ -held 100,192,250,500,1000,2000,4000 -held-nofile 1024go run ./cmd/bench_resources/ -held 100,192,250,500,1000,2000,4000 -held-nofile 1024 -held-credentials 100El modo de sesiones
Sección titulada «El modo de sesiones»-sessions <counts> mide lo que guarda el transporte con estado: una sesión.
Es la medición con la que se dimensionó el
techo de sesiones.
El servidor arranca con --stateless=false, y cada paso abre a la vez un número
conocido de sesiones, repartidas por turnos entre -sessions-credentials, cada
una un initialize en el protocolo 2025-11-25 seguido de
notifications/initialized. Con -sessions-stream, cada sesión abre además su
flujo independiente, el GET que un cliente con estado mantiene abierto para
las notificaciones del servidor, y lo mantiene abierto durante el paso. Antes
del primer paso cada credencial abre una sesión, lista sus herramientas y la
borra, para que el pool tenga una entrada construida para cada credencial y la
entrada no se cuente en el precio de las sesiones.
Un paso se muestrea igual que uno de llamadas retenidas (la misma regla de
asentamiento, las mismas cifras, la misma consulta a /health por una conexión
propia), mientras todas las sesiones que abrió están inactivas. Después hace
ping a cada sesión a la que el servidor dio un identificador, sin que cada ping
espere más que la consulta a /health, y cuenta las que respondieron: ese es el
número de sesiones que mantiene el servidor, visto desde fuera, y el recuento se
detiene en el primer ping que no obtuvo ninguna respuesta, porque un proceso que
no aceptó una conexión no aceptará la siguiente. Cada apertura se clasifica como
abierta, rechazada (un 503, el estado con el que responde el techo de
sesiones, conservando su primer texto) o fallida, una sesión se valora como el
crecimiento del paso sobre el proceso en reposo dividido entre las sesiones
abiertas en la muestra, y antes del siguiente paso se cierra cada flujo y se
borra cada sesión.
-sessions-nofile <n> arranca el servidor bajo un límite de descriptores
exactamente como -held-nofile. El servidor dimensiona su techo de sesiones a
partir del techo de llamadas retenidas que le da ese límite, 96 bajo 1024. El
modo escribe bench/sessions.json, que no se versiona, no dibuja nada y se
rechaza si -sessions-json nombra el registro publicado; no se puede combinar
con -held ni con -fairness. make bench-sessions ejecuta la escalera con la
que se midió el techo, bajo un límite de 1024 y con el flujo de cada sesión
abierto.
| Flag | Tipo | Por defecto | Descripción |
|---|---|---|---|
-sessions | string | "" | Recuentos de sesiones abiertas a la vez, separados por comas y en orden ascendente; vacío ejecuta la matriz |
-sessions-credentials | int | 1 | Credenciales entre las que se reparten las sesiones |
-sessions-nofile | int | 0 | Límite de descriptores con el que arranca el servidor; 0 hereda el de este proceso (no en Windows) |
-sessions-stream | bool | false | Abre el flujo independiente de cada sesión y lo mantiene abierto durante el paso |
-sessions-json | string | bench/sessions.json | Documento que se escribe; se rechaza si nombra el registro publicado |
# Lo que cuesta una sesión con estado, con y sin su flujo independientego run ./cmd/bench_resources/ -sessions 100,500,1000,2000,4000go run ./cmd/bench_resources/ -sessions 50,96,100,500,1000,2000,4000 -sessions-nofile 1024 -sessions-streamEl resto de los flags de la orden, y el modo de equidad, están en la referencia de órdenes.