Benchmarking
El comando de benchmark mide operaciones de la API de RouterOS contra un router real. Está pensado para desarrollo y planificación de capacidad, no para despliegues normales.
Comando
Sección titulada «Comando»Compila y ejecuta el benchmark:
go run ./cmd/benchmarkLa ruta de configuración es opcional y por defecto es config/test.yaml:
go run ./cmd/benchmark config/test.yamlEl benchmark lee la sección de MikroTik del archivo YAML seleccionado, se conecta a RouterOS y después ejecuta operaciones a nivel de API.
Qué mide
Sección titulada «Qué mide»- Adiciones/eliminaciones individuales de direcciones IPv4 e IPv6 en address-list.
- Llamadas de búsqueda y listado de address-list.
- Llamadas de creación, búsqueda y eliminación de reglas de firewall.
- Tiempos de adición/listado/búsqueda/eliminación secuenciales de lotes IPv4.
El benchmark usa direcciones de prueba de prefijos de documentación como 198.51.100.0/24 y 2001:db8::/32, pero aun así escribe en las address lists y los menús de firewall de RouterOS configurados.
Ejemplo de salida
Sección titulada «Ejemplo de salida»Connected to: lab-router
=== SINGLE OPERATION BENCHMARKS (RouterOS API) === Add single IPv4 35ms OK Find IPv4 (1 entry) 12ms OK Remove IPv4 by .id 18ms OK
=== BATCH ADD BENCHMARKS (sequential via API) === Add 100 IPv4 (sequential) 4s (40ms/ip, failures=0)Usa los números para comparar versiones de RouterOS, modelos de hardware, API con TLS frente a texto plano y latencia de red.
Para el rendimiento real de arranque del bouncer, prefiere las pruebas funcionales de CAPI, porque la reconciliación usa adiciones masivas basadas en scripts y eliminaciones basadas en pool, no solo llamadas secuenciales a la API.
Resultados en el mundo real
Sección titulada «Resultados en el mundo real»Estas cifras provienen de la suite de pruebas funcionales de CAPI (tests/functional/) ejecutada contra un MikroTik RB5009, no de la herramienta de operaciones individuales cmd/benchmark anterior. Consulta Arquitectura: Pool de conexiones y Adición masiva basada en scripts para conocer los mecanismos detrás de estos números.
| Escenario | Resultado |
|---|---|
| Adición optimista cache-first (la dirección aún no está en el router) | ~1–3 ms por operación |
| Adición check-first (listar entradas antes de añadir, evitado por la caché) | ~400 ms por IP |
Adición masiva, ~24.400 entradas, LAN del router: /execute · script guardado · una llamada a la API por entrada | 21,2 s · 35,5 s · 22,8 s |
Adición masiva, ~24.400 entradas, 36 ms de ida y vuelta: /execute · script guardado · api con 16 sesiones | 32,7 s · 69,6 s · 75,6 s |
| Bulk-add completo en RB5009, ~22.000 entradas de origen CAPI | ~29 s de bulk, ~34 s desde el arranque |
Las dos filas de comparación de la adición masiva son más recientes y salen del propio bouncer: arranques en frío en RouterOS 7.24.4, medidos el 2026-10-04, tres rondas en la LAN y dos a 36 ms. Mediante /execute un bloque de 100 entradas es un viaje de ida y vuelta; un script guardado necesita cuatro y escribe su código completo en el log del router, unas 6.850 líneas de log para esta carga. Una llamada a la API por entrada cuesta alrededor de 1 ms en la LAN, pero cada una paga el viaje de ida y vuelta completo: a 33 ms, una sola sesión tardó 13 minutos.
La diferencia entre cache-first (~1-3 ms) y check-first (~400 ms) es la razón por la que existe la caché de direcciones en memoria descrita en Arquitectura: permite al bouncer saltarse el viaje de ida y vuelta listar-y-añadir de RouterOS para las direcciones que ya conoce.
Para despliegues a escala de CAPI (decenas de miles de entradas), consulta también Blocklists de CAPI y Ajuste de rendimiento para orientación sobre el dimensionado de pool_size.
La primera reconciliación, según el método de adición masiva
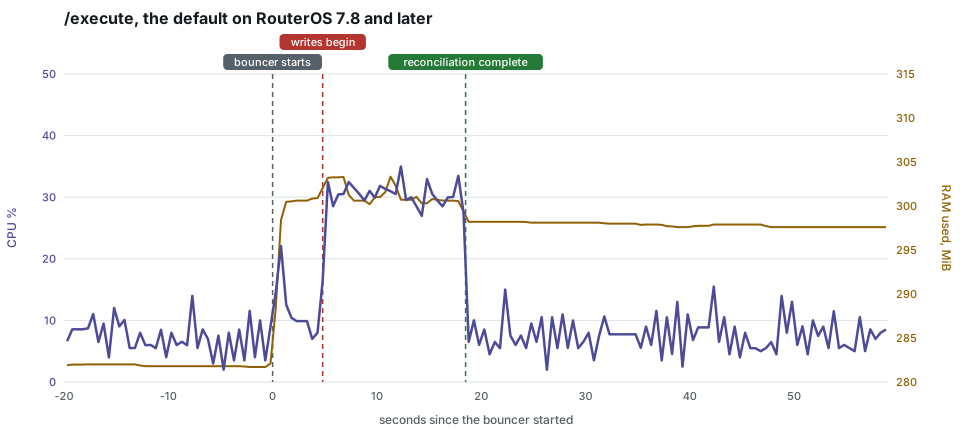
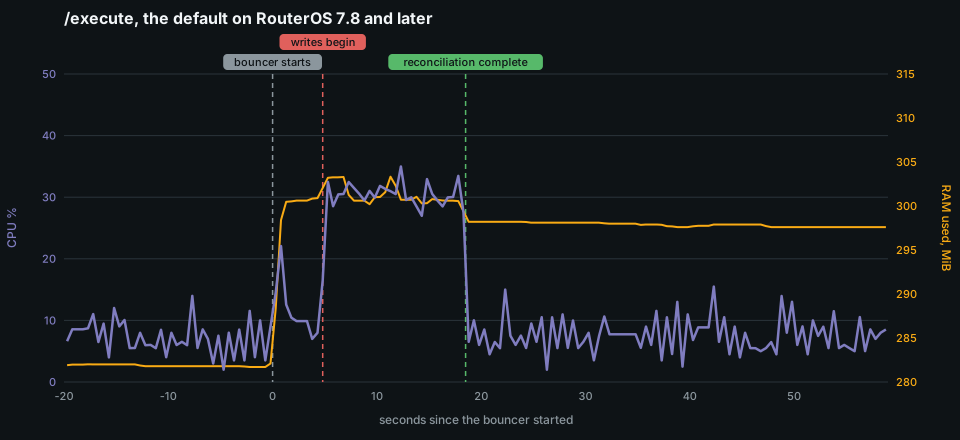
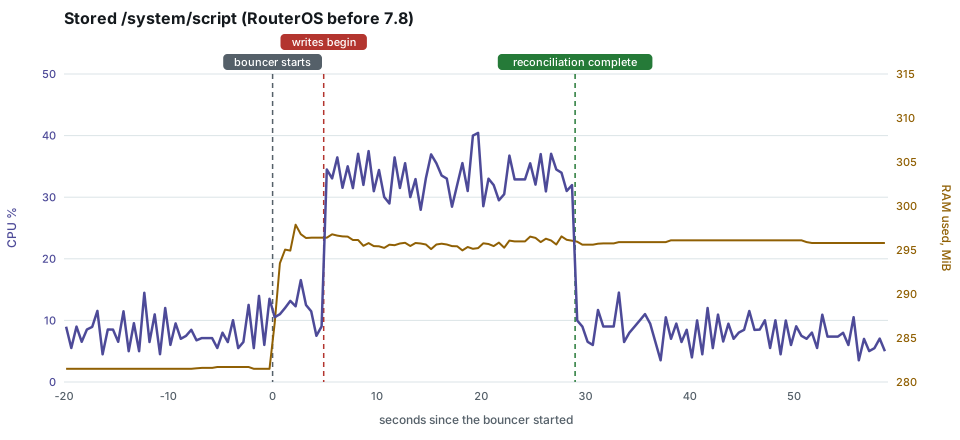
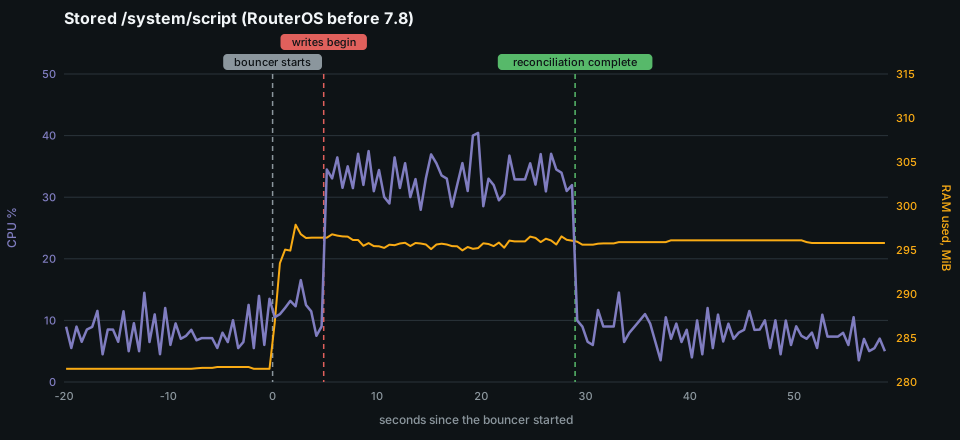
Sección titulada «La primera reconciliación, según el método de adición masiva»Tres capturas del RB5009UG+S+ de producción (RouterOS 7.24.4), tomadas el 2026-10-05 con pocos minutos de diferencia, una por cada forma en que el bouncer puede cargar una lista de direcciones. Cada una carga las mismas 17.361 decisiones —16.861 IPv4 y 500 IPv6, la lista comunitaria de CrowdSec más las decisiones locales— en listas vacías: el bouncer parado, las dos listas borradas, 60 segundos para estabilizarse y 30 más sin tocar nada, y entonces se arrancó el servicio. La CPU y la RAM son la serie de 10 Hz del colector de mikroscope, leída de InfluxDB después (cómo), así que nada tocó el router durante una ventana. Los marcadores son las propias líneas del log del bouncer, con la marca de tiempo de cuando se escribieron. Las tres gráficas comparten ejes, y cada punto es la media de cinco muestras de 100 ms.
/executeejecutó la release 1.7.0 tal como funciona en producción: elbulk_add_method: scriptpor defecto ypool_size: 10.apiejecutó la misma release y configuración conbulk_add_method: api./system/scriptguardado ejecutó la release 1.6.0, cuyo método script siempre guarda un script. Construye el mismo script y lo ejecuta con el mismo código que la 1.7.0 conserva para RouterOS anterior a 7.8rc1, así que esto es lo que cuesta ese camino, medido en 7.24.4; un RouterOS más antiguo puede ejecutarlo más rápido o más despacio.
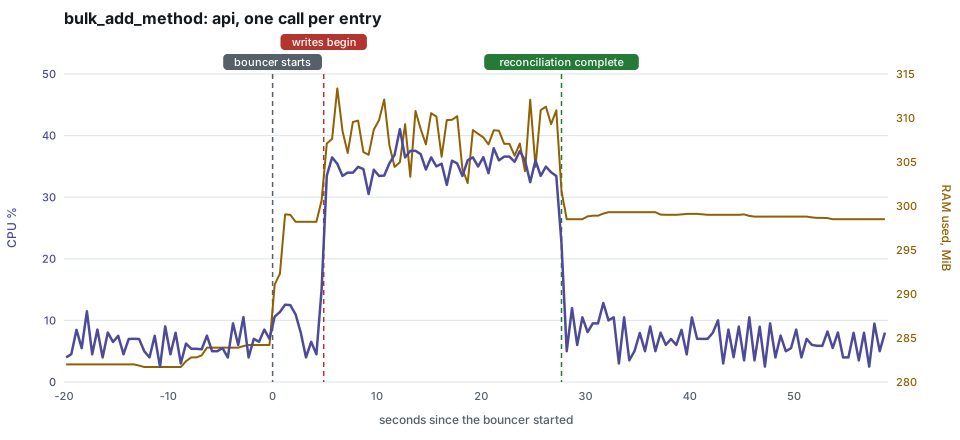
| Método | Escritura | Arranque a listo | CPU media al escribir | Pico de 100 ms | CPU sobre reposo | RAM pico / después |
|---|---|---|---|---|---|---|
/execute (por defecto, 7.8rc1+) | 13,7 s | 18,5 s | 30,6% | 45,1% | 12,8 núcleo·s | +23,0 / +15,7 MiB |
/system/script guardado (antes de 7.8) | 24,1 s | 29,0 s | 33,2% | 52,7% | 24,3 núcleo·s | +18,4 / +14,3 MiB |
api, pool_size: 10 | 22,8 s | 27,7 s | 35,3% | 47,4% | 26,5 núcleo·s | +34,2 / +15,9 MiB |
“Escritura” va de la primera entrada a la última. “CPU sobre reposo” es el tiempo de los cuatro núcleos por encima de su media en los 20 segundos previos al arranque, sumado a lo largo de la escritura, y las columnas de RAM se miden contra esos mismos 20 segundos.
Lo que tienen en común las tres es la altura: entre como entre, una importación
ocupa alrededor de un tercio de los cuatro núcleos de este router. Lo que cambia
es cuánto dura. /execute termina en 13,7 segundos frente a 24,1 de un script
guardado, así que el router le dedica más o menos la mitad de tiempo de CPU, y
además un script guardado escribe en el log del router el código completo de
cada bloque, mientras que /execute no escribe nada. api queda entre ambos
en tiempo, 22,8 segundos, y es el más caro en CPU: en la propia LAN del router,
diez sesiones compiten en vez de solaparse, y es el único método cuya RAM se mueve durante la importación, hasta
34 MiB mientras las sesiones están ocupadas.
Los primeros cinco segundos son iguales en las tres: el bouncer conecta su pool, crea sus reglas de firewall y recoge las decisiones de la LAPI antes de escribir nada, y la mayor parte del escalón de RAM cae ahí, antes de que exista una sola entrada. Después, el router guarda unos 15 MiB más que con el bouncer parado, sea cual sea el método que llenó la lista.
El router además ejecuta dos tareas periódicas propias, cada una cada 30 segundos según su reloj. Suben la CPU entre 20 y 40 puntos durante 0,3 a 1,2 segundos, hasta unos 3 segundos con la lista llena, y se ejecutan esté o no el bouncer: su calendario se leyó de los 90 segundos previos a cada arranque, con el bouncer parado. Las gráficas y la tabla las suavizan para que no se lean como trabajo del bouncer: dentro de cada uno de esos tramos, cada muestra se sustituye por la media del segundo anterior y el posterior, en CPU y en RAM. Mientras el bouncer arranca o escribe, el tramo conserva la duración que tenía la tarea con el bouncer parado, así que no se suaviza nada de la importación.
Los datos de cada gráfica están en el repositorio junto a ella:
docs/src/data/perf-first-reconcile-<método>.csv (rel_s,cpu_pct,ram_used_mib,
una fila cada 100 ms, la serie sin tocar), su -markers.csv y su
-background.csv, los tramos suavizados. docs/scripts/render-perf-charts.mjs
dibuja con ellos los dos temas, con la paleta leída de theme.css, y
pnpm run charts:check hace fallar el build de la documentación cuando una
gráfica del repositorio ya no coincide con sus datos o con la paleta.
La captura de 2026-08, 22.000 entradas
Sección titulada «La captura de 2026-08, 22.000 entradas»Antes de las tres anteriores, esta página tenía una sola captura, tomada con el
script guardado, el único método que tenía entonces el bouncer. La gráfica siguiente es una única captura continua de 70 segundos del RB5009 de
producción, tomada con un muestreador a 10 Hz que lee /proc/stat en el propio
router (la sección siguiente dice con qué instrumento, y qué lo ha sustituido).
Cubre los tres estados con los que un operador se encuentra de verdad: el
router ocioso con el bouncer parado y la lista de direcciones vacía, la
primera reconciliación importando ~22.000 entradas, y el estado tranquilo
posterior con la lista completa cargada. La CPU se lee en el eje izquierdo, la
RAM en el derecho, y los marcadores discontinuos salen de los propios
timestamps del log del bouncer. Cada punto es la media de cinco muestras de
100 ms; los picos sub-segundo alcanzan el 57% en rebanadas sueltas de 100 ms
durante el import.
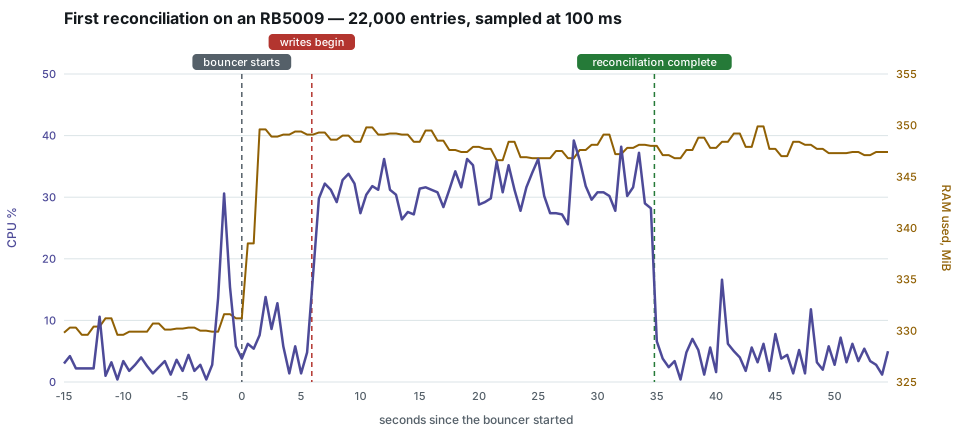
El import es la meseta: aproximadamente un 31% sostenido durante ~26 segundos, repartido entre los cuatro cores con el pool de conexiones rotando picos de un solo core del 50–100%. La RAM es la parte tranquila de la historia, con una sorpresa en el cuándo: el escalón de ~19 MiB cae al conectar, antes de importar una sola entrada — y 22.000 entradas después no se ha movido más. Mantener la lista le cuesta al router casi nada; la memoria no es donde muerde esta carga, la CPU durante las lecturas de la lista, sí. El tramo ocioso también enseña los propios blips de fondo del router — un dispositivo real nunca es una línea plana.
De dónde salió esta captura
Sección titulada «De dónde salió esta captura»La serie la tomó cmd/perfmon, un instrumento de un solo uso que este
repositorio llevó desde la 1.5.0 hasta que la 1.6.0 lo eliminó: compilaba en cruzado un
muestreador de /proc/stat, lo cargaba en el router como contenedor, empujaba
lotes a Loki, se traía una ventana en CSV y dibujaba este par de SVG. Ese
código ya no está — mikroscope hace
el mismo trabajo como herramienta mantenida, y la sección siguiente explica
cómo usarla. Lo que el instrumento midió se queda:
docs/src/data/perf-lifecycle.csv (141 filas, a 100 ms una de otra) y
perf-lifecycle-markers.csv (tres marcadores, leídos del propio log del
bouncer) siguen versionados junto a la figura, así que cualquier número de
arriba se puede comprobar contra los datos de los que salió.
Lo que eso cuesta, dicho aquí y no descubierto más tarde: los dos SVG ya no
se pueden regenerar desde este repositorio. Se dibujaron con la paleta del
propio sitio leída de theme.css, así que un cambio de paleta ya no les
llegará. Son un artefacto congelado del 2026-08-26, no una salida del build —
toma una paleta nueva, o una pregunta nueva, como razón para volver a capturar
y no para recolorear. El propio plot de mikroscope tampoco sustituye a ese generador:
dibuja tres paneles sobre un mismo eje de tiempo a partir de una grabación, con su propia
paleta y sin variante oscura, así que produce otra figura, no ésta.
El método, tal y como se midió: CPU de /proc/stat a 10 Hz en un contenedor
del router, RAM de /proc/meminfo una vez por segundo, porque la memoria no se
movía a 100 ms en esta carga. El cpu-load propio de RouterOS se actualiza
solo una vez por segundo, así que los scripts no pueden ver por debajo de eso,
y ésa es toda la razón por la que existía un muestreador. El protocolo de
captura: parar el bouncer, borrar ambas listas de direcciones, dejar asentar el
router, y arrancar el bouncer grabando a través de la primera reconciliación
hasta el régimen estable.
Dos cosas que el dataset no lleva, y esta página tampoco llevaba antes: la
versión de RouterOS de esa captura concreta — las demás cifras de referencia de
aquí se tomaron en 7.22.1 — y cómo se derivó ram_used_mib. El propio verbo
capture del instrumento emitía mem_avail_kib y mem_free_kib, así que la
columna dibujada como RAM pasó por un paso de conversión que nunca vivió en el
repositorio. La columna de CPU es la salida del instrumento; la de RAM está a
una operación aritmética de distancia.
Medir el router: usa mikroscope
Sección titulada «Medir el router: usa mikroscope»cmd/perfmon ya no está porque se convirtió en su propio proyecto.
mikroscope es ese proyecto: un agente
estático en Go que corre en el router, en un contenedor scratch, y lee el
/proc del kernel compartido de 1 a 100 Hz, 10 por defecto, más una CLI en tu
máquina que lo instala, graba una ventana con marcadores, dibuja la gráfica o
funciona como colector hacia once destinos. Se lleva los pasos de despliegue,
el constructor de imágenes sin Docker y el cliente de la API de RouterOS que
nacieron aquí, con la atribución en cada paquete — así que lo que sigue es el
mismo mecanismo, ahora probado, publicado y documentado por su cuenta.
Lo que el observador le cuesta al router está medido, no prometido: 2,69% de un core y 13,2 MiB residentes con el valor por defecto de 10 Hz del instalador, leídos del propio cgroup del agente en un RB5009UG+S+ (4 × 1,4 GHz Cortex-A72, RouterOS 7.24.2), en una ventana de 300 segundos en régimen estable con el colector enviando a InfluxDB 3, el 2026-09-18. Es la misma placa en la que se toman las cifras de este bouncer, que es lo que hace comparables las dos; no se traslada a ninguna otra placa. Lo que cuesta explica cómo se toma la cifra y cómo tomarla en tu propio dispositivo.
Poner el agente en el router
Sección titulada «Poner el agente en el router»curl -fsSL https://raw.githubusercontent.com/jmrplens/mikroscope/main/install.sh | bash
export MIKROSCOPE_ROUTER=admin@192.168.88.1mikroscope doctor # comprobación previa, de solo lecturamikroscope install --ephemeral # lista cada comando que va a ejecutar, pregunta y escribemikroscope status # qué hay instalado, y si responde--ephemeral conserva la única costumbre que merece la pena heredar del
instrumento antiguo: fuerza la raíz del contenedor a la tmpfs y lo registra con
start-on-boot=no, así que un instrumento no deja rastro en un dispositivo que
solo tomaba prestado. Déjalo fuera para un despliegue que deba sobrevivir a un
reinicio. Sin toolchain de Go en tu máquina, añade
--remote-image jmrplens/mikroscope-agent:latest y el propio router se
descarga la imagen — no se compila nada y no se sube nada.
Las dos trampas del firewall por defecto que se comían el tráfico del
muestreador de este repositorio son las mismas dos, y el instalador de
mikroscope se encarga de ambas: la regla raw drop the rest (in-interface-list=!LAN) descarta cada paquete de un veth que no esté en la
lista de interfaces LAN, y drop local if not from default IP range coincide
con un origen fuera de la address-list LANs. El síntoma conviene reconocerlo
porque nada lo registra: el ICMP al contenedor responde mientras su TCP
saliente no genera entrada de conntrack ni contador de masquerade, y el sniffer
no muestra nada. Las dos trampas del
cortafuegos es la versión
larga.
Grabar una ventana y dibujarla
Sección titulada «Grabar una ventana y dibujarla»mikroscope record --for 3m --out first-reconcile # una línea escrita aquí se convierte en marcador# en otra terminal: systemctl start cs-routeros-bouncermikroscope plot --in first-reconcile # first-reconcile.svg, deterministarecord escribe first-reconcile.jsonl, .csv y .markers.csv, y
mikroscope mark --out first-reconcile "reconciliación completa" añade un
marcador a una grabación que ya existe. Arranca en la muestra más reciente del
agente, así que ponlo en marcha antes que el bouncer — o pasa --from-start
para traerte primero lo que el anillo del agente aún guarde, 60 segundos con el
valor por defecto del instalador.
El protocolo de captura de la tanda de 2026-08 es la parte que decide si los números significan algo, y no ha cambiado nada de él: parar el bouncer, borrar ambas listas de direcciones, dejar asentar el router, empezar a grabar y solo entonces arrancar el bouncer. Una cosa sí ha mejorado. La memoria ahora se lee y se envía en cada tick y no una vez por segundo — en el dispositivo de referencia los niveles de memoria del kernel se movían unas 24 veces por segundo, así que un suelo ahí habría tirado movimiento real — de modo que la serie de RAM vuelve al ritmo del muestreador en lugar de a 1 Hz.
Leer la serie de 10 Hz sin tocar el router
Sección titulada «Leer la serie de 10 Hz sin tocar el router»La gracia de un colector es que la ventana que quieres ya está guardada.
mikroscope forward --influx http://influx:8181 --influx-db mikroscope escribe
el nivel de kernel en InfluxDB 3 de forma continua — el token sale de
MIKROSCOPE_INFLUX_TOKEN, nunca de un flag — y a partir de ahí una pregunta
sobre CPU es una consulta, no un despliegue. El token le llega a curl por la
entrada estándar, como fichero --config, porque un argumento lo ve cualquier
usuario local con ps y -H "Authorization: …" es un argumento como otro
cualquiera:
printf 'header = "Authorization: Bearer %s"\n' "$MIKROSCOPE_INFLUX_TOKEN" | curl -s --config - --get \ http://influx:8181/api/v3/query_sql \ --data-urlencode "db=mikroscope" \ --data-urlencode "format=json" \ --data-urlencode "q=SELECT time, avg(busy_ratio) * 100 AS cpu_pct FROM mikroscope_cpu WHERE host = 'router' AND time >= '2026-09-24T18:00:00Z' AND time < '2026-09-24T18:02:00Z' GROUP BY time ORDER BY time"host es lo que fije el --host-tag del colector — router por defecto, y rb5009
en el colector que está detrás de las cifras de este proyecto. busy_ratio es una fracción
por core entre 0 y 1, calculada por el sink y recortada a 1, así que promediarla sobre la
etiqueta cpu en un mismo instante da el porcentaje de todos los cores que el dataset
retirado llamaba cpu_pct.
Los deltas de ticks en crudo están en la misma fila, con el intervalo real de
la muestra dt_ns, si prefieres hacer tú esa aritmética — y una tasa calculada
sobre el periodo nominal en lugar del real es exactamente el tipo de error del
que habla la sección siguiente.
| Columna del dataset retirado | De dónde sale ahora la misma magnitud |
|---|---|
cpu_pct | avg(busy_ratio) * 100 sobre la etiqueta cpu de mikroscope_cpu en un time |
ram_used_mib | (total_kb - available_kb) / 1024.0 de mikroscope_mem, una fila por tick |
perf-lifecycle-markers.csv | una línea escrita en record, o mikroscope mark después |
scripts/router-perf-query.sh, en este repositorio, envuelve ese curl para
el puñado de preguntas que este proyecto se hace de verdad — CPU por core,
memoria, descartes de softnet, el coste del propio agente y la continuidad de
la ventana — y toma MIKROSCOPE_INFLUX_URL y MIKROSCOPE_INFLUX_TOKEN del
entorno, los mismos nombres de variable que usa el colector. Su cabecera
documenta las dos trampas que conviene conocer: los contadores de softnet y
del observador son deltas por muestra, así que hay que sumarlos y no restar
extremos, y un bin parcial de date_bin en el borde de una ventana promedia
sobre menos de un segundo.
Medidas en InfluxDB y
SQL es la lista de
columnas de cada tabla, y el sink de
InfluxDB es lo que las
escribe. Que Grafana lea esa misma base de datos es el camino más corto a una
gráfica; el grafana/dashboard.json de este repositorio es solo de Prometheus
y cubre las métricas del bouncer, no el kernel del router.
Medir contra un router en producción
Sección titulada «Medir contra un router en producción»Dos costumbres separan un número accionable de uno que engaña, y ambas se aprendieron por las malas afinando este bouncer.
Intercala las variantes. Un router no es una máquina en silencio: enruta tráfico, ejecuta su propio trabajo de fondo y deriva a lo largo de los minutos. Medir la variante A un rato y luego la B otro rato atribuye esa deriva al cambio. Altérnalas — A, B, A, B — dentro de la misma conexión y el mismo minuto, y compara muestras emparejadas. La primera comparación in situ de la reducción de proplist se hizo en dos ventanas separadas y dio −2%; la versión intercalada dio −11,2%, con las 48 parejas favoreciendo el mismo lado. El mismo código y el mismo router; solo cambió el calendario.
Desconfía de una curva que no es monótona. Barrer el tamaño de bloque una vez por valor, en secuencia, produjo esto:
bloque 50 6,926sbloque 100 4,679sbloque 250 9,760s <- el doble que sus vecinos por ambos ladosbloque 500 5,395sbloque 1000 6,194sNingún modelo de coste produce esa forma.
Reporta una dispersión, no un solo número. El arreglo evidente — intercalar los tamaños entre rondas y quedarse con el mejor tiempo de cada uno — sigue siendo incorrecto, solo que de forma menos evidente. El mínimo es un estimador defendible cuando el ruido es unilateral, pero tira justo la información que decide si la comparación significa algo. Repetido guardando todas las muestras, el mismo barrido dice:
| bloque | mediana | media | IQR |
|---|---|---|---|
| 50 | 5,78 s | 6,86 s | 1,76 s |
| 100 | 5,06 s | 5,31 s | 0,22 s |
| 250 | 5,31 s | 6,39 s | 2,47 s |
| 500 | 5,50 s | 5,77 s | 0,84 s |
| 1000 | 4,36 s | 5,75 s | 2,55 s |
La dispersión dentro de un mismo tamaño llega a 2,55 s, mientras que la distancia entre el mejor y el peor tamaño es de 1,43 s. El ruido de una variante es mayor que la diferencia entre variantes, así que el barrido no resuelve nada — y, en efecto, qué tamaño “gana” depende del estimador: mediana y mínimo eligen 1.000, la media elige 100. Reportar solo el mejor de tres rondas habría escondido todo eso tras una tabla de aspecto impecable.
La conclusión sobrevivió, porque nunca dependió del ranking: insertar una fila domina, así que ningún tamaño de bloque en este rango mueve el import de forma medible. Pero la primera redacción enunciaba un modelo de coste de dos términos con dos cifras significativas que los datos no sostienen.
Un reflejo útil: antes de creerte un resultado, pregunta qué más cambió entre las dos mediciones. Casi siempre es el tiempo.
Lista de comprobación de seguridad
Sección titulada «Lista de comprobación de seguridad»- Confirma que el destino es un router de laboratorio.
- Usa address lists de prueba dedicadas cuando sea posible.
- Mantén
command_timeoutlo bastante alto para dispositivos lentos. - Revisa el router tras una interrupción y elimina cualquier comentario
benchmark-*si una ejecución se detiene a medias.